Índice: cómo optimizar un chatbot de IA en WhatsApp
Si quieres optimizar un chatbot de IA en WhatsApp, el primer paso no es cambiar de modelo, sino mirar qué lee antes de cada respuesta. En el artículo anterior de esta serie, sobre cuánto cuesta cada forma de responder con IA en WhatsApp Business API, vimos que casi toda la factura de tokens es lectura y que un asistente montado deprisa puede leer cinco veces más de lo necesario para dar la misma respuesta. Este artículo explica cómo se evita, y qué conviene pedir a tu proveedor o a tu Equipo técnico en cada paso (para entenderlo no hace falta programar).
Si aún no tienes claro para qué casos sirve un asistente así, empieza por nuestra guía de chatbot para WhatsApp Business. Fisio Norte es un caso ficticio e ilustrativo: una red de centros de fisioterapia inventada, con conversaciones y cifras de ejemplo, que usamos de hilo conductor igual que en el artículo anterior. Las tarifas de los proveedores sí son reales y están consultadas el 14 de octubre de 2026.
Por qué optimizar un chatbot de IA en WhatsApp empieza por lo que lee
Un chatbot de IA conectado a WhatsApp Business API no solo escribe la respuesta: antes tiene que leer todo lo que necesita para escribirla.
En cada turno, la IA vuelve a leer las instrucciones, el conocimiento del negocio, las acciones que puede ejecutar, el historial de la conversación y el mensaje del cliente. Lo que lee se factura como entrada y lo que escribe, como salida. La salida cuesta más por token, pero es mucho más corta, así que pesa menos en la cuenta final.
Recordatorio: casi toda la factura de tokens es lectura (caso Fisio Norte, ilustrativo)
Fisio Norte responde a la pregunta «¿Cuánto cuesta una sesión?». Con la configuración inicial, la IA lee 20.940 tokens para escribir 120. Con la optimizada, el cliente recibe la misma respuesta, pero la IA lee 3.935 y escribe 90. Así se reparte, bloque a bloque (el artículo anterior recogía los tres primeros ajustes, que dejaban la lectura en 4.140; aquí se suman también la conversación y las respuestas más cortas):
| Bloque | Antes (tokens) | Después (tokens) | Ahorro |
|---|---|---|---|
| Instrucciones | 2.000 | 900 | −1.100 |
| Conocimiento | 18.000 | 2.500 | −15.500 |
| Acciones | 500 | 300 | −200 |
| Historial | 400 | 195 | −205 |
| Mensaje del cliente | 40 | 40 | 0 |
| Total de entrada (lectura) | 20.940 | 3.935 | −17.005 (−81 %) |
| Respuesta (salida) | 120 | 90 | −30 |
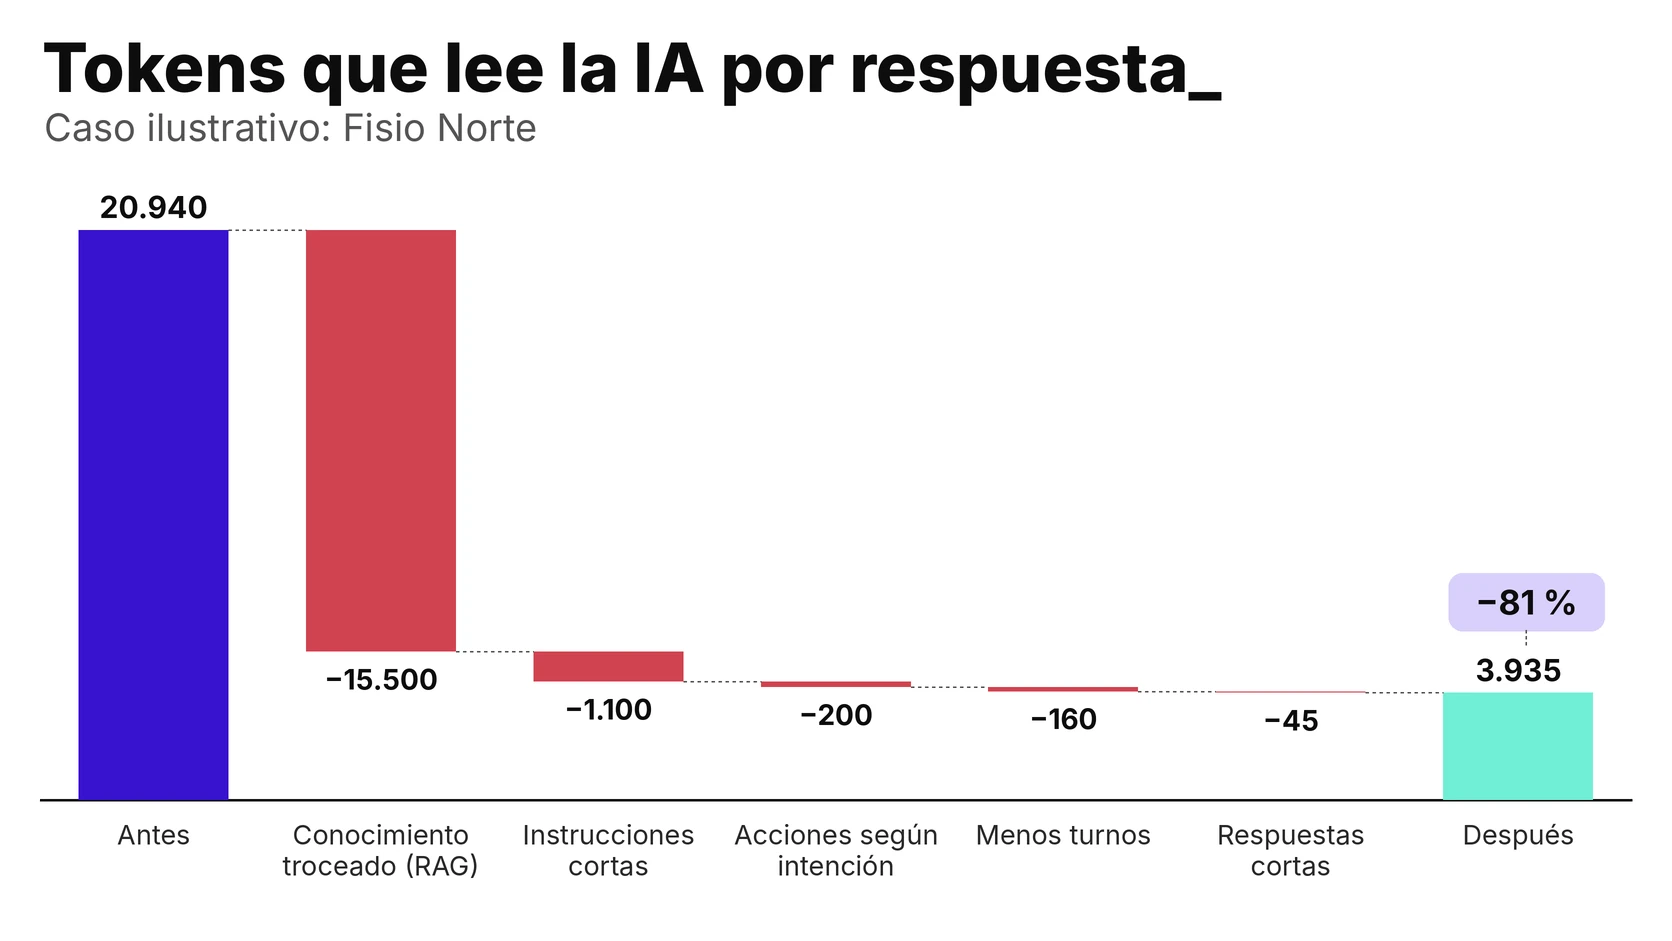
Con una IA avanzada (GPT-6.1 Sol, a 2 $ de entrada y 10 $ de salida por millón de tokens; 1 € = 1,14 $) y la tarifa de servicio de Meta (0,0166 € por respuesta), mil respuestas cuestan 54,39 € antes y 24,29 € después. Es la base sobre la que se hacen las cuentas del resto del artículo.
Conocimiento troceado (RAG): cómo preparar la información
El conocimiento es el bloque que más pesa (18.000 de los 20.940 tokens de Fisio Norte), y por eso es donde más se ahorra. La técnica que lo consigue se llama RAG, y casi todo su resultado depende de cómo se prepare la información.
Qué es el RAG, explicado sin tecnicismos
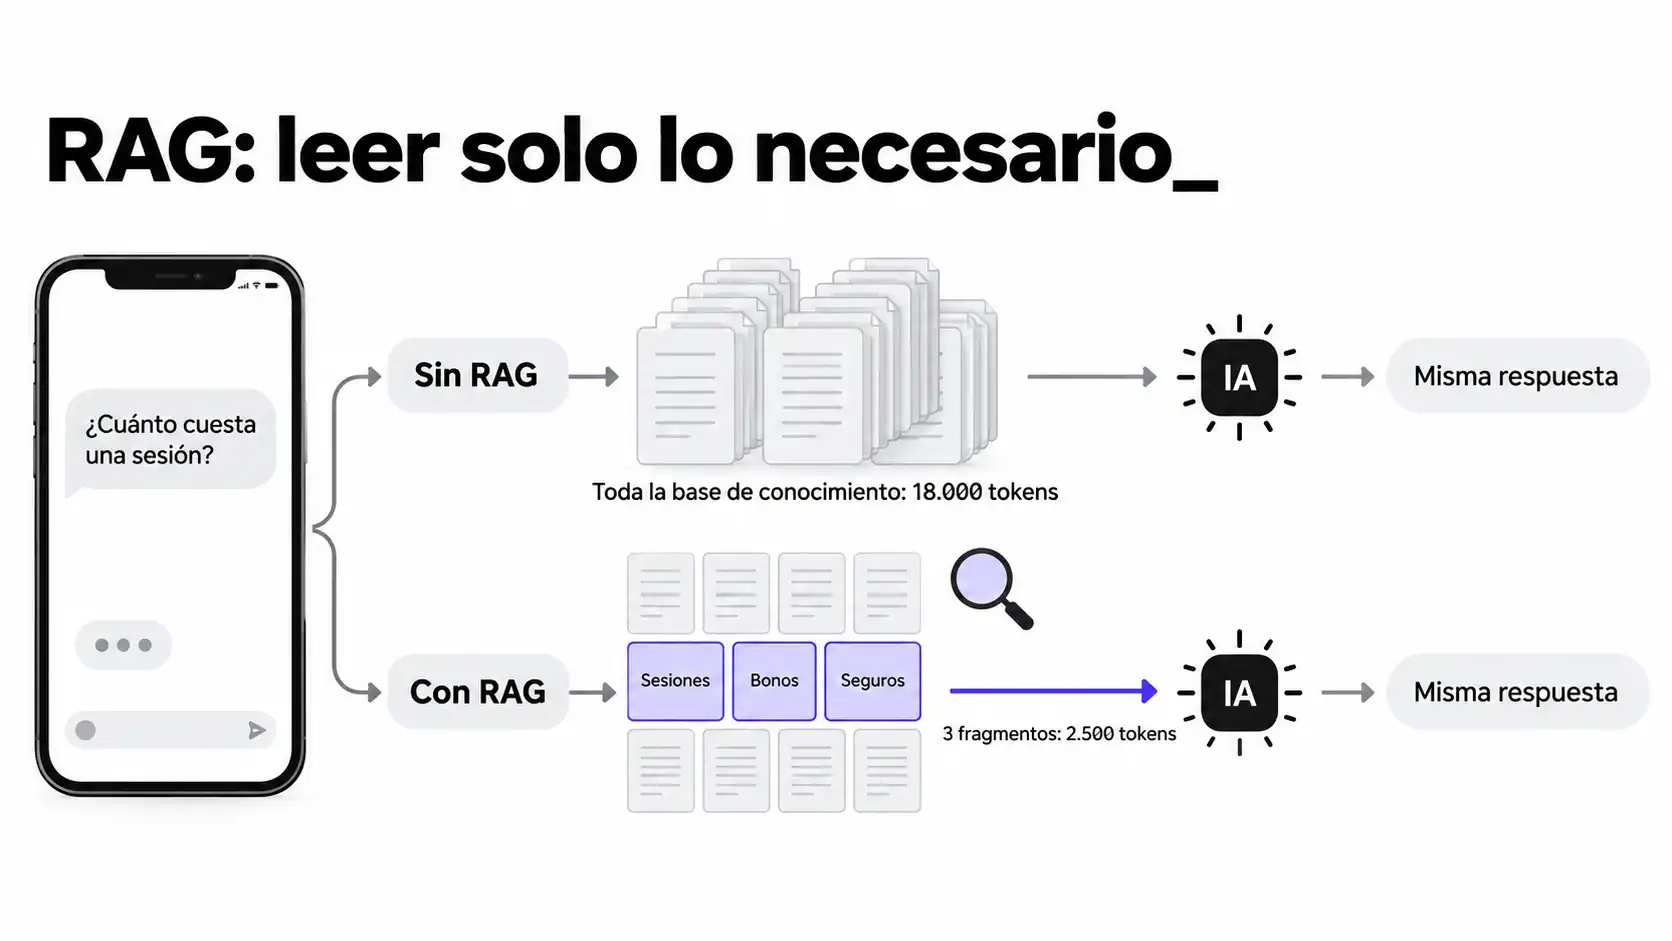
Piensa en la diferencia entre entregar a una persona recién llegada el manual completo de la empresa antes de cada llamada, o darle un buen índice para que consulte solo la página que necesita. El RAG es ese índice (siglas en inglés de generación aumentada por recuperación): la información se divide en fragmentos, se guarda en un buscador que entiende el significado (no solo las palabras exactas) y, cuando llega una pregunta, solo se envían a la IA los fragmentos que se parecen a ella.
Para el cliente, la respuesta no cambia; lo que cambia es la lectura.
Cómo trocear: por secciones y tamaño orientativo de los fragmentos
Trocear bien importa más que trocear mucho. Un fragmento debe contener una sola idea completa: una tarifa con sus condiciones, una política de cancelación, el horario de un centro. Si se corta a mitad de una explicación, la IA recibe medias verdades; si se mezclan temas, recibe ruido.
- Por secciones, no por páginas. Cada fragmento sigue la estructura natural del contenido (un título y lo que cuelga de él), en lugar de un corte automático cada cierto número de líneas.
- Que se entienda por sí solo. Conviene que el fragmento incluya el contexto mínimo (por ejemplo, «Centro de Gijón: horario»), porque la IA no verá el resto del documento.
- Tamaño orientativo. Como punto de partida (es un supuesto de trabajo, no una norma de ningún proveedor), fragmentos de unos 300 a 900 tokens, es decir, de unas 200 a 650 palabras. En Fisio Norte, los tres fragmentos que pide la pregunta de precios suman 2.500 tokens.
- Un fragmento por cada duda que se repite. Las preguntas más habituales de los clientes son el mejor mapa de cómo dividir el conocimiento.
Cuántos fragmentos recuperar por pregunta
Es un equilibrio entre quedarse corto y volver a leer de más. Pocos fragmentos pueden dejar fuera la respuesta, y demasiados acercan el asistente al que lo lee todo. La pregunta de precios de Fisio Norte necesita tres (sesiones, bonos y seguros). Como punto de partida orientativo, entre tres y cinco, que se ajusta mirando dónde falla el asistente: si falta información, se sube; si lee de más, se baja.
Y una regla de seguridad: si ningún fragmento se parece a la pregunta, lo correcto es que el asistente lo diga y pase la conversación a una persona, en lugar de improvisar una respuesta.
Por qué Markdown es mejor punto de partida que un PDF
Un PDF está pensado para imprimir, no para trocear: mezcla columnas, cabeceras, pies de página y tablas que, al convertirse en texto, suelen desordenarse, y el fragmento llega a la IA con frases cortadas o datos descolocados. Markdown (un formato de texto en el que los títulos, las listas y las tablas se marcan de forma sencilla) conserva la estructura: cada título indica dónde empieza un fragmento y cada tabla sigue siendo una tabla.
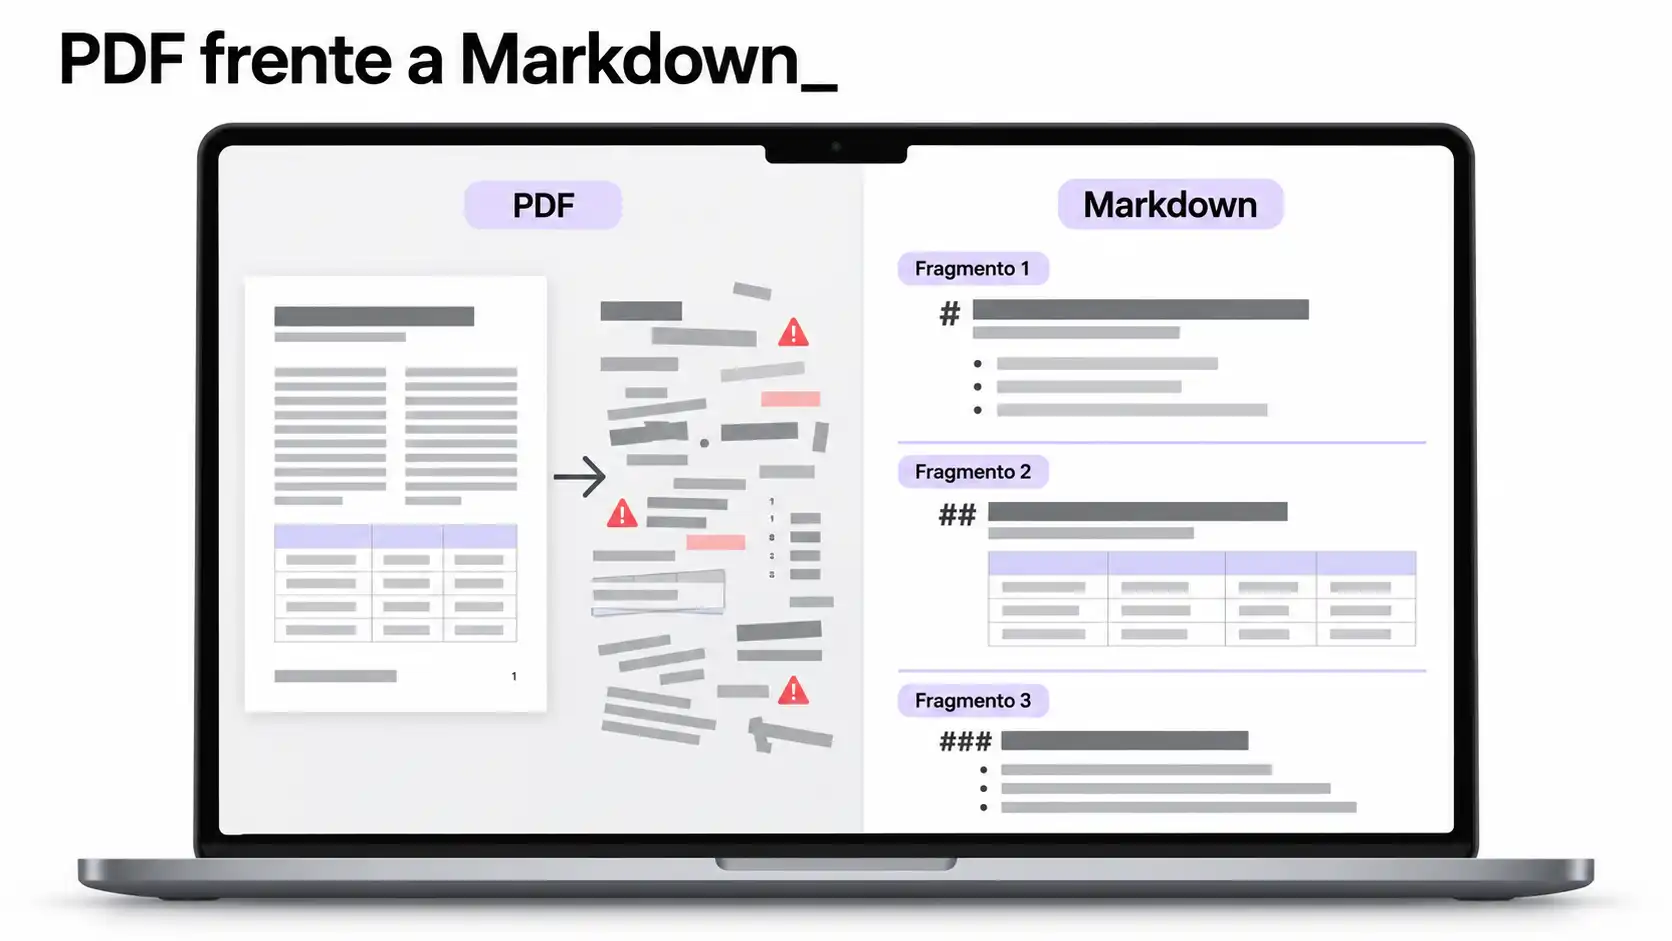
Si hoy tu conocimiento está en PDF, el primer paso es pasarlo a Markdown y revisarlo a mano una vez. Es un trabajo que se hace una sola vez y que mejora todo lo que viene después.
Qué pedir a tu proveedor
- ¿Cómo se trocea mi conocimiento? ¿Y quién lo revisa cuando cambia un precio o un horario?
- ¿Cuántos fragmentos recupera por pregunta? ¿Puedo ver cuáles usó en cada respuesta?
- ¿Qué hace cuando ningún fragmento responde? ¿Pasa a una persona o responde igualmente?
Caché de entrada: cómo funciona en OpenAI, Anthropic y Google
La caché de entrada es un descuento por repetir el mismo comienzo de mensaje. Cuando la parte inicial de lo que lee la IA es idéntica a la de una petición reciente, el proveedor no la procesa de nuevo y cobra mucho menos por esos tokens. Para aprovecharla hay que entender qué parte del mensaje es fija.
Qué parte del mensaje se puede cachear (y cuál no)
La caché reconoce el principio del mensaje, y solo si coincide exactamente. En cuanto algo cambia, todo lo que viene después deja de estar en caché. Por eso importa el orden: primero lo estable y, al final, lo que cambia en cada turno. La documentación de OpenAI lo recomienda así (contenido estable primero y dinámico al final) y la de Anthropic fija el orden herramientas, instrucciones y mensajes.
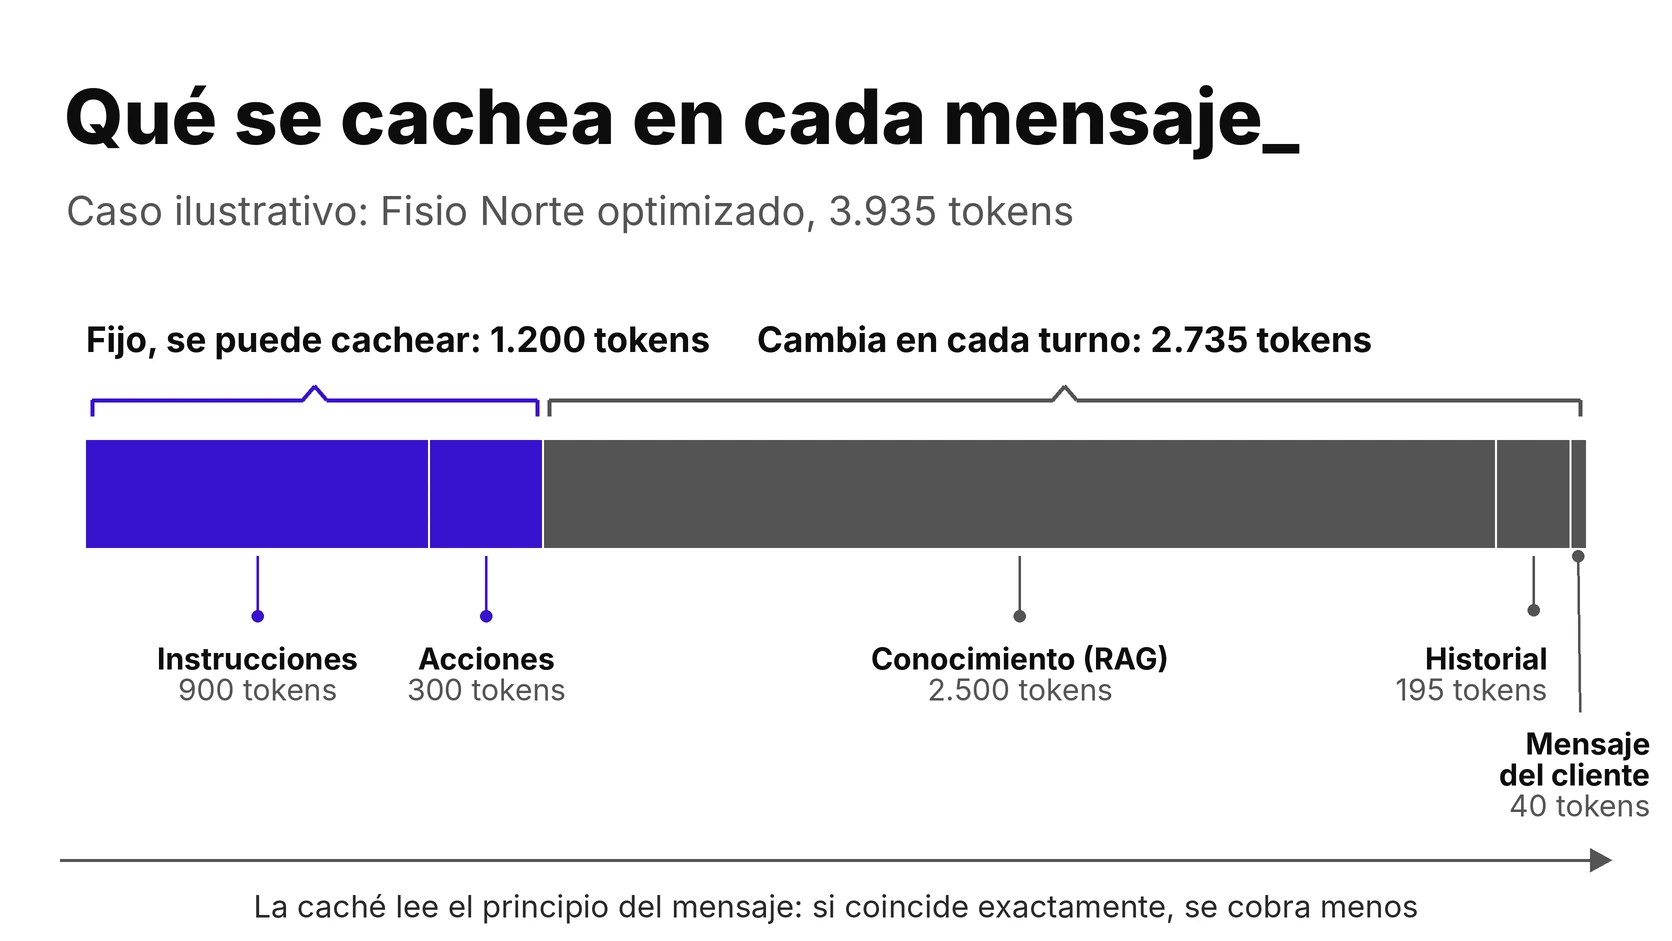
- Se puede cachear: las instrucciones, la definición de las acciones y cualquier conocimiento que se envíe siempre igual.
- No se puede cachear (o casi nunca acierta): los fragmentos que el RAG cambia en cada pregunta, el historial, el mensaje del cliente y cualquier dato variable (la hora, el nombre del cliente) colocado al principio.
Automática o por activar: descuento, mínimo de tokens y duración en cada proveedor
Los tres grandes proveedores ofrecen caché, pero no la activan, la cobran ni la conservan igual. Esto es lo que dice su documentación oficial a 14 de octubre de 2026 (precios por millón de tokens de entrada):
| Proveedor | ¿Hay que activarla? | Mínimo para cachear | Leer de la caché | Escribir en la caché | Cuánto dura |
|---|---|---|---|---|---|
| OpenAI | Automática en los modelos compatibles. Desde GPT-5.6 hay además un modo explícito opcional | 1.024 tokens | 0,1 veces el precio de entrada en general; 0,05 veces en GPT-6.1 Sol (0,10 $ frente a 2 $) | 1,25 veces el precio de entrada desde GPT-5.6 (antes, sin cargo adicional) | Al menos 30 minutos desde la última escritura o reutilización (GPT-5.6 y posteriores) |
| Anthropic (Claude) | Sí: se indica en la petición, de forma automática o con puntos de corte concretos | De 512 a 4.096 tokens según el modelo | 0,1 veces en general; 0,05 veces en Claude Opus 5.5 y Sonnet 5.5 | 1,25 veces (5 minutos) o 2 veces (1 hora) | 5 minutos por defecto, que se renuevan con cada uso; 1 hora opcional |
| Google (Gemini) | Implícita por defecto desde Gemini 2.5. La explícita es opcional en algunos modelos | De 2.048 a 4.096 tokens según el modelo | El 10 % del precio de entrada (descuento del 90 %) en Gemini 3.8 Flash y 3.1 Pro Preview | La explícita cobra almacenamiento por hora (0,50 $ por millón en 3.8 Flash; 4,50 $ en 3.1 Pro Preview) | La página consultada no lo indica |
Los tres coinciden en lo importante: rebajan entre un 90 % y un 95 % la lectura repetida en los modelos de la tabla y exigen un comienzo idéntico y lo bastante largo. Cambian en cómo se activa, cuánto dura y cuánto cuesta escribir. Y, en todos, por debajo del mínimo no hay error ni descuento: el mensaje se procesa como si no existiera la caché.
El coste de escribir en caché cuando no se reutiliza
Escribir en caché cuesta más que no cachear: un 25 % más en OpenAI (desde GPT-5.6) y en Anthropic con la duración de 5 minutos, y el doble con la de una hora. Ese sobrecoste se paga cada vez que la petición no encuentra su comienzo ya guardado, y se recupera con los aciertos.
Con las tarifas de GPT-6.1 Sol la cuenta es sencilla: cada fallo cuesta 0,50 $ más por millón de tokens (2,50 $ de escribir frente a 2 $ de leer sin caché) y cada acierto ahorra 1,90 $ (2 $ frente a 0,10 $). La caché empieza a compensar cuando acierta una de cada cinco respuestas (un 21 % aproximado). Por debajo de ese ritmo, cachear sale más caro que no hacerlo.
Qué pedir a tu proveedor
- ¿Está activada la caché en mi asistente? ¿Y con qué modelo?
- ¿Qué porcentaje de las peticiones acierta en caché? El dato sale de los registros de uso del proveedor de IA.
- ¿Qué va al principio del mensaje y qué al final? Lo estable debe ir primero.
RAG y caché: cuándo se suman y cuándo compiten
Parecen dos formas de ahorrar lo mismo, y lo son hasta cierto punto: ambas abaratan lo que la IA lee. Pero actúan sobre partes distintas y no siempre se suman. El RAG reduce cuánto se lee; la caché reduce cuánto cuesta leer lo que se repite.
Si todo el conocimiento viaja siempre igual, la caché lo abarata mucho. Pero si el RAG lo cambia en cada pregunta, esa parte deja de ser un comienzo estable y ya no se cachea. Veámoslo con números.
Fisio Norte con y sin caché: la comparativa en euros
Volvamos a Fisio Norte (caso ilustrativo, el mismo del artículo anterior) con las tarifas de GPT-6.1 Sol. En la configuración inicial, 20.500 de los 20.940 tokens son fijos (instrucciones, conocimiento y acciones), así que se pueden cachear. En la optimizada solo son fijos 1.200 (instrucciones y acciones), porque los fragmentos del RAG cambian con cada pregunta.
| Configuración de Fisio Norte | Sin caché | Caché con el 50 % de aciertos | Caché con el 100 % de aciertos |
|---|---|---|---|
| Antes: todo el conocimiento en cada turno (20.940 tokens) | 54,39 € | 41,80 € | 20,22 € |
| Después: RAG e instrucciones, acciones, historial y respuestas recortados (3.935 tokens) | 24,29 € | 23,56 € | 22,29 € |
Conviene contarlo con honestidad: con aciertos perfectos, la caché sola gana. El asistente sin optimizar baja a 20,22 €, por debajo de los 22,29 € del optimizado. En puro coste de tokens, si la caché acertara siempre, no recortar lo que se lee podría salir más barato. En este ejemplo, esa ventaja desaparece por debajo de un 95 % de aciertos aproximado.
Y un 100 % de aciertos es un techo teórico. Con la mitad de aciertos, el asistente sin optimizar cuesta 41,80 € y el optimizado, 23,56 €. Por eso el RAG sigue mereciendo la pena aunque la caché esté activada:
- El coste es más predecible. Con RAG, entre la caché perfecta y no usar caché hay unos 2 € por cada 1.000 respuestas (de 22,29 € a 24,29 €). Sin RAG hay unos 34 € (de 20,22 € a 54,39 €), y con pocos aciertos puede salir aún más caro que sin caché, por el coste de escribir.
- Escala mejor. Si la base de conocimiento crece, lo que se lee crece con ella; con RAG, apenas cambia, porque solo viajan los fragmentos relevantes.
- La IA lee menos ruido. Menos texto irrelevante en cada respuesta suele ayudar a que se centre en lo que importa. No es un dato que se pueda dar por hecho: se comprueba con preguntas reales (lo vemos en el apartado de medición).
El ritmo de conversaciones decide si la caché compensa
La caché solo se paga sola si el comienzo vuelve a usarse antes de que caduque. Mucho tráfico concentrado favorece a la caché: una tienda con cientos de conversaciones por hora mantiene su comienzo siempre vigente. Poco tráfico, o con huecos largos, favorece al RAG: una clínica pequeña que recibe diez mensajes al día, con horas entre uno y otro, dejaría caducar la caché casi siempre y pagaría la escritura sin recoger el descuento.
Hay otros dos detalles. El primero: resumir o recortar el historial puede reiniciar la caché, según advierte la documentación de OpenAI, así que conviene que quien configure el asistente decida cuándo se resume en lugar de hacerlo en cada turno. El segundo: los 1.200 tokens fijos del asistente optimizado apenas superan el mínimo de OpenAI (1.024) y no llegan al de los modelos Gemini (2.048 o 4.096), de modo que en Google la caché no actuaría.
En resumen, la combinación habitual es cachear lo estable y recuperar con RAG lo variable. En Fisio Norte, añadir caché al asistente ya optimizado ahorra unos 2 € por cada 1.000 respuestas, porque lo fijo es poco. La caché aporta más cuanto mayor es la parte fija y más tráfico hay; el RAG, cuanto mayor es el conocimiento y menos se usa de él en cada pregunta.
Qué pedir a tu proveedor
- ¿Cuántas conversaciones al día tiene mi número? Con eso se decide si la caché va a acertar.
- ¿Cuántos tokens fijos tiene mi asistente? Si no llegan al mínimo del modelo, la caché no actúa.
- ¿Cuándo se resume el historial? ¿Se hace en cada turno o a intervalos?
Instrucciones cortas y acciones según la intención
Después del conocimiento, los dos bloques que más se pueden recortar sin perder nada son las instrucciones y las acciones. En Fisio Norte pasaron de 2.500 a 1.200 tokens entre los dos.
Reglas concisas y ejemplos fuera del mensaje principal
Un manual de dos páginas con ejemplos se relee entero en cada respuesta. Las instrucciones deben decir cómo responder, no enseñar todos los casos: el tono, los límites, cuándo pasar a una persona y el formato de la respuesta. Los ejemplos largos (cómo contestar una queja, cómo explicar una tarifa) se guardan aparte, como un fragmento más del conocimiento, y solo viajan cuando la pregunta los necesita. Así bajaron las instrucciones de Fisio Norte de 2.000 a 900 tokens.
- Una instrucción por idea, en frases cortas y sin repetirse.
- Lo que nunca cambia, al principio. Además de ordenar el mensaje, deja ese bloque listo para la caché.
Solo las acciones que pide cada tipo de pregunta
Cada acción que la IA puede ejecutar (pedir una cita, consultar un pedido, pasar a una persona) tiene que describirse en el mensaje. Con ocho acciones son unos 500 tokens en cada respuesta, aunque la pregunta sea de precios y no haga falta ninguna. La solución es detectar primero la intención de la pregunta y cargar solo las acciones que le corresponden. Se puede hacer con reglas sencillas o con un modelo ligero y barato que clasifica la pregunta antes de pasársela al principal.
Para una pregunta de precios, Fisio Norte solo necesita «pedir cita» y «pasar a persona»: 300 tokens en lugar de 500. Y si el asistente consulta datos del cliente en el CRM (el estado de una cita, un bono), esa acción solo se carga cuando la pregunta trata de eso, como ocurre en la integración de WhatsApp Business con Zoho CRM.
Qué pedir a tu proveedor
- ¿Cuántos tokens ocupan las instrucciones y las acciones? Y cuántas acciones carga en cada respuesta.
- ¿Dónde viven los ejemplos largos? ¿Viajan siempre o solo cuando hacen falta?
Historial más corto, con botones y WhatsApp Flows
El historial es el único bloque que crece con cada turno: en la décima respuesta, la IA relee los nueve intercambios anteriores. En Fisio Norte, con conversaciones cortas, ocupa 400 tokens; en una conversación larga ocuparía bastante más.
Acortar o resumir la conversación
Hay dos maneras de recortarlo. Conservar solo los últimos turnos (por ejemplo, los cuatro últimos mensajes; es un supuesto de ejemplo) es lo más simple y predecible. Resumir lo anterior en pocas líneas (qué quiere el cliente, qué se le ha dicho, qué falta) conserva más contexto, pero exige cuidar que el resumen no pierda un dato importante. Y, como vimos en la caché, tocar el historial puede reiniciarla.
Menos turnos, menos historial que releer
La forma más eficaz de acortar el historial es que la conversación tenga menos turnos. Los botones, las listas y los WhatsApp Flows (formularios que se abren dentro de la propia conversación) recogen de una vez lo que de otro modo llevaría varios mensajes. Lo explicamos en cómo reducir el coste de WhatsApp Business API.
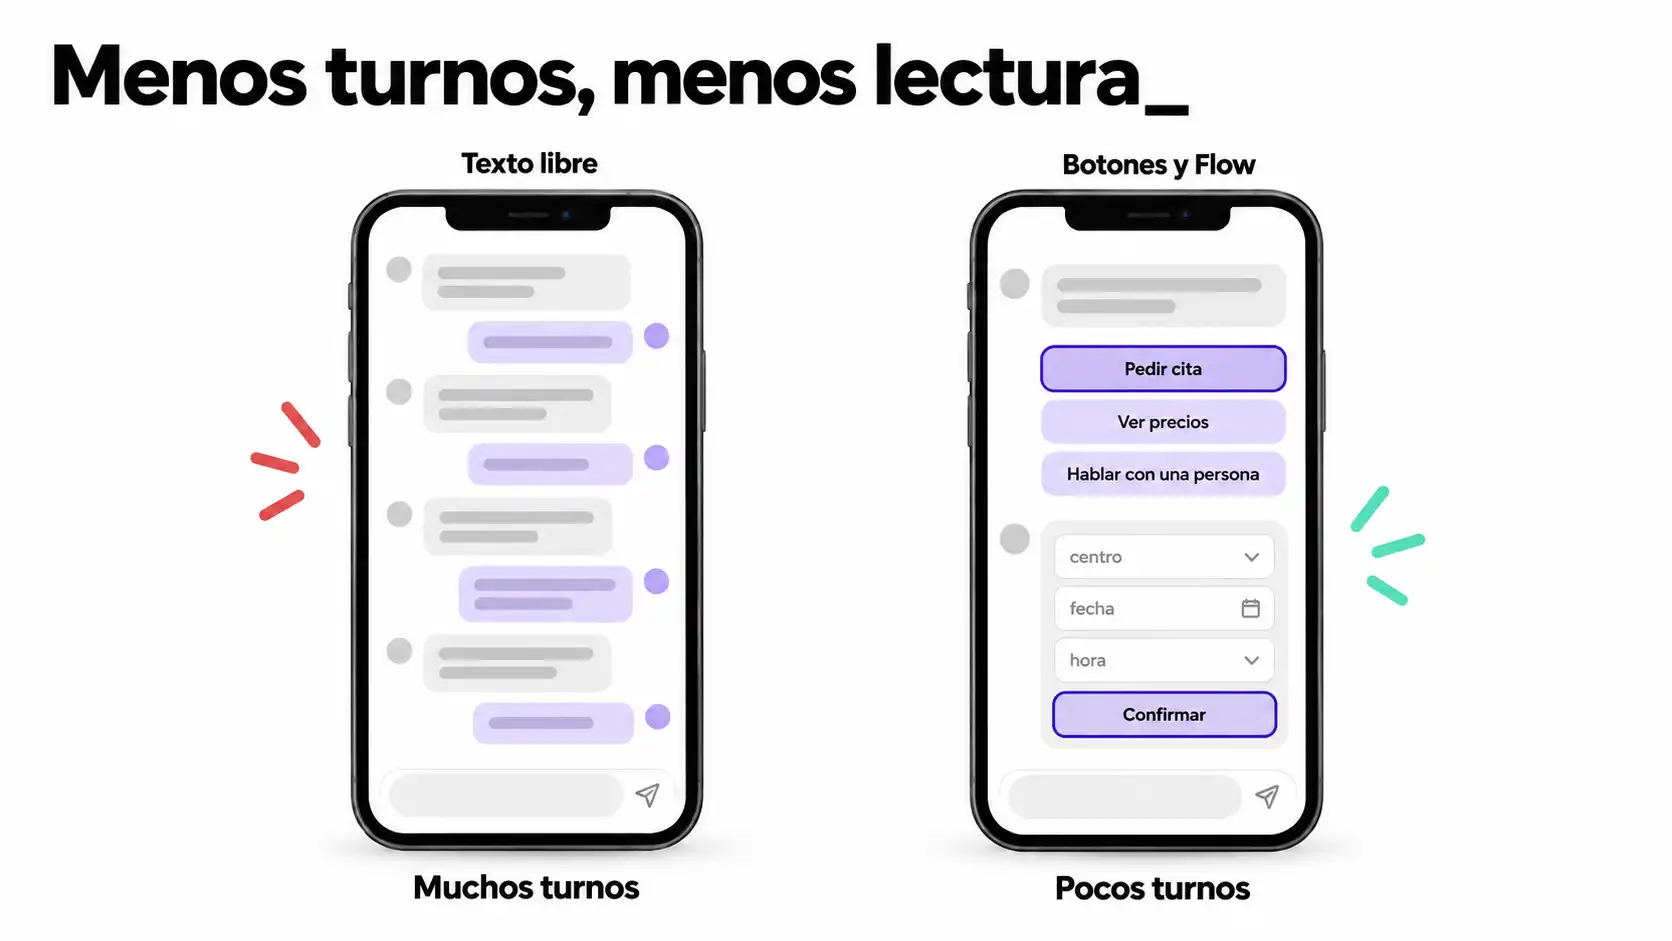
Cada turno que se evita ahorra el mensaje y también todo lo que habría que releer después. Si quieres montarlo con nosotros, lo hacemos dentro de nuestro servicio de WhatsApp Business Platform.
Qué pedir a tu proveedor
- ¿Cuántos turnos del historial se envían? ¿Se recorta, se resume o viaja entero?
- ¿Qué pasos pueden resolverse con botones o Flows? Cada uno es un turno menos.
Respuestas cortas: cómo controlar la salida
La salida es el token más caro: en el modelo de ejemplo, un token escrito cuesta cinco veces más que uno leído (10 $ frente a 2 $ por millón en GPT-6.1 Sol). Pedir al asistente que conteste en dos o tres frases, sin repetir la pregunta del cliente, baja la respuesta de Fisio Norte de 120 a 90 tokens.
El ahorro directo es pequeño, pero también acorta el historial que se relee en los turnos siguientes (en Fisio Norte pasa de 240 a 195 tokens). Hay un límite: una respuesta demasiado corta empeora la atención. La instrucción útil no es «sé breve» a secas, sino «responde lo que se pregunta, en dos o tres frases, y ofrece ampliar». Si el cliente necesita más, un botón (por ejemplo, «Ver detalle») lo da sin que la IA escriba de más.
Qué pedir a tu proveedor
- ¿Hay un límite de longitud de respuesta configurado? ¿Y cuál es?
- ¿Cómo se comprueba que las respuestas cortas siguen resolviendo? Por ejemplo, con las conversaciones que acaban en una persona.
El agente de IA de Meta: qué puedes controlar y qué no
Todo lo anterior vale para una IA de terceros conectada a tu plataforma. El agente de IA de Meta funciona de otra manera: se cobra por tokens, a 2 $ por millón según su documentación, y el resto de tarifas de Meta las explicamos en el cambio de precios de WhatsApp Business API. Conviene saber qué margen deja.
Fuentes de conocimiento
Según la documentación de Meta, el agente se alimenta de información del negocio, preguntas frecuentes, sitios web y archivos, y se le dan instrucciones sobre tono, prioridades y voz de marca. También puede conectarse a tus sistemas mediante APIs y suscripciones a webhooks, y traspasar el control a tu aplicación en determinados eventos.
Es decir, la parte de preparar bien el conocimiento sigue siendo tuya: unas preguntas frecuentes desactualizadas o un sitio web desordenado pueden dar respuestas desactualizadas o desordenadas también aquí. Lo que la documentación consultada no detalla es cómo se trocea esa información ni cuántos fragmentos lee el agente en cada respuesta.
Consumo de tokens
Meta indica que un mensaje consume habitualmente entre 20.000 y 25.000 tokens (unos 4 a 5 céntimos de dólar, entre 3,5 y 4,4 céntimos de euro), y que los mensajes más sencillos cuestan menos. Eso equivale a entre 35 y 44 € por cada 1.000 respuestas. La documentación consultada no menciona qué modelo usa ni qué lee en cada turno, y no describe ajustes de caché, de fragmentos o de historial como los de este artículo.
Además, el cargo por tokens se aplica también dentro de la ventana gratuita de 72 horas de Click-to-WhatsApp. En la práctica, con el agente de Meta controlas las instrucciones, la calidad de las fuentes y cuándo pasar la conversación a una persona; la lectura de cada respuesta la gestiona Meta.
Qué pedir a tu proveedor
- ¿Qué fuentes alimentan al agente y quién las actualiza? Un precio que cambia debe cambiar también ahí.
- ¿Qué datos de consumo recibimos cada mes? Tokens por mensaje y coste total.
- ¿Cuándo y cómo pasa la conversación a una persona? ¿Quién la recibe?
Cómo medir si la optimización funciona
Optimizar sin medir es adivinar. Bastan tres medidas para empezar, y todas salen de los datos de uso que da el proveedor de IA.
Tokens por respuesta y porcentaje de aciertos de caché
Cada respuesta de la API informa de cuántos tokens se han leído, cuántos venían de caché y cuántos se han escrito (por ejemplo, cached_tokens en OpenAI o cache_read_input_tokens en Anthropic). Con ellos se calcula la media de tokens de entrada por respuesta (el objetivo es que baje sin que baje la calidad) y el porcentaje de aciertos de caché (el objetivo es superar con holgura el 21 % de equilibrio que vimos antes).
Coste por 1.000 respuestas
Es la unidad que hemos usado en toda la serie, porque permite comparar opciones distintas. Se calcula sumando tokens de entrada por su precio, tokens de salida por el suyo y la tarifa de servicio de Meta (0,0166 € por respuesta a partir de la 1.001 del mes y por número). Para ir más allá del coste y medir lo que aporta el asistente, te sirve nuestra guía de cómo calcular el ROI de un chatbot.
Calidad: que ahorrar no empeore la respuesta
Un asistente que lee menos pero responde peor no ahorra nada. Antes de tocar nada, guarda entre 30 y 50 preguntas reales (es un supuesto de trabajo, ajustable) con la respuesta que consideras correcta, y vuelve a lanzarlas tras cada cambio. Fíjate en tres cosas: si responde lo correcto, si inventa algo que no está en el conocimiento y si pasa a una persona cuando debe.
Si quieres revisar cómo está configurado el asistente de tu empresa, en nuestra página de WhatsApp Business para empresas te explicamos cómo trabajamos: WhatsApp Business para empresas.
Qué pedir a tu proveedor
- ¿Qué informe de consumo me das cada mes? Tokens por respuesta, aciertos de caché y coste por 1.000 respuestas.
- ¿Con qué preguntas de prueba se valida cada cambio? ¿Puedo ver los resultados?
Y si quieres poner números a tu volumen, nuestra calculadora de costes de WhatsApp estima tu factura de Meta desde el 1 de octubre y las horas de equipo que liberas al automatizar respuestas. No incluye el consumo de la IA, que depende del modelo y de lo que lea tu asistente (para eso sirven las cuentas de este artículo):
¿Cuánto te sube la factura de WhatsApp Business API?
Desde el 1 de octubre Meta cobra las respuestas de servicio. Pon tus datos de un mes normal y mira aquí mismo cuánto cambia tu factura.
- 0,0166 €cada respuesta de servicio a España, a partir de la 1.001 del mes
- 1.000respuestas gratis al mes por número
- 0,075 €cada plantilla de marketing a España
El precio oficial de Meta por mensaje de marketing a España es 0,0585 €; el resto es el margen habitual de plataformas y revendedores. Las respuestas de servicio no llevan margen.
Preguntas frecuentes
¿Qué es el RAG en un chatbot de WhatsApp?
Es la técnica que divide el conocimiento del negocio en fragmentos y envía a la IA solo los que se parecen a la pregunta del cliente, en lugar de todo el conocimiento. La respuesta es la misma, pero la IA lee mucho menos, y la lectura es lo que más pesa en la factura.
¿La caché de entrada es automática o hay que activarla?
Depende del proveedor. En OpenAI es automática (a partir de 1.024 tokens), en Google la implícita viene activada por defecto y en Anthropic hay que indicarla en la petición. Pregunta a tu proveedor si está activa y qué porcentaje de aciertos tiene.
¿Cuánto se ahorra optimizando un chatbot de IA?
Depende del punto de partida y del modelo. En el caso ilustrativo de Fisio Norte, la lectura baja un 81 % (de 20.940 a 3.935 tokens) y el coste por 1.000 respuestas con una IA avanzada pasa de 54,39 € a 24,29 €. Con una IA ligera el ahorro es pequeño, porque casi todo es tarifa de Meta.
¿Recortar lo que lee la IA empeora sus respuestas?
No tiene por qué, pero hay que comprobarlo con preguntas reales. Guarda un conjunto de preguntas con su respuesta correcta y vuelve a lanzarlas tras cada cambio. Si falta información en alguna respuesta, sube el número de fragmentos recuperados.
¿Se puede optimizar el agente de IA de Meta?
Solo en parte. Puedes cuidar las fuentes de conocimiento y las instrucciones, pero la documentación de Meta consultada no describe ajustes sobre qué lee en cada respuesta ni sobre su consumo de tokens.
Revisamos qué lee tu asistente y dejamos que lea solo lo que necesita_
Sobre las fuentes de este artículo
Caché de OpenAI: guía de prompt caching y precios de la API. Anthropic: guía de prompt caching. Google: caché de contexto y precios de la API de Gemini. Meta: precios de mensajes sin plantilla y visión general de Meta Business Agent. Consultados el 14 de octubre de 2026; tipo de cambio de la serie: 1 € = 1,14 $. Los cálculos son de Reinicia y Fisio Norte es un caso ilustrativo. Los tamaños y el número de fragmentos, los turnos de historial y las preguntas de prueba son supuestos de trabajo, no recomendaciones de ningún proveedor.